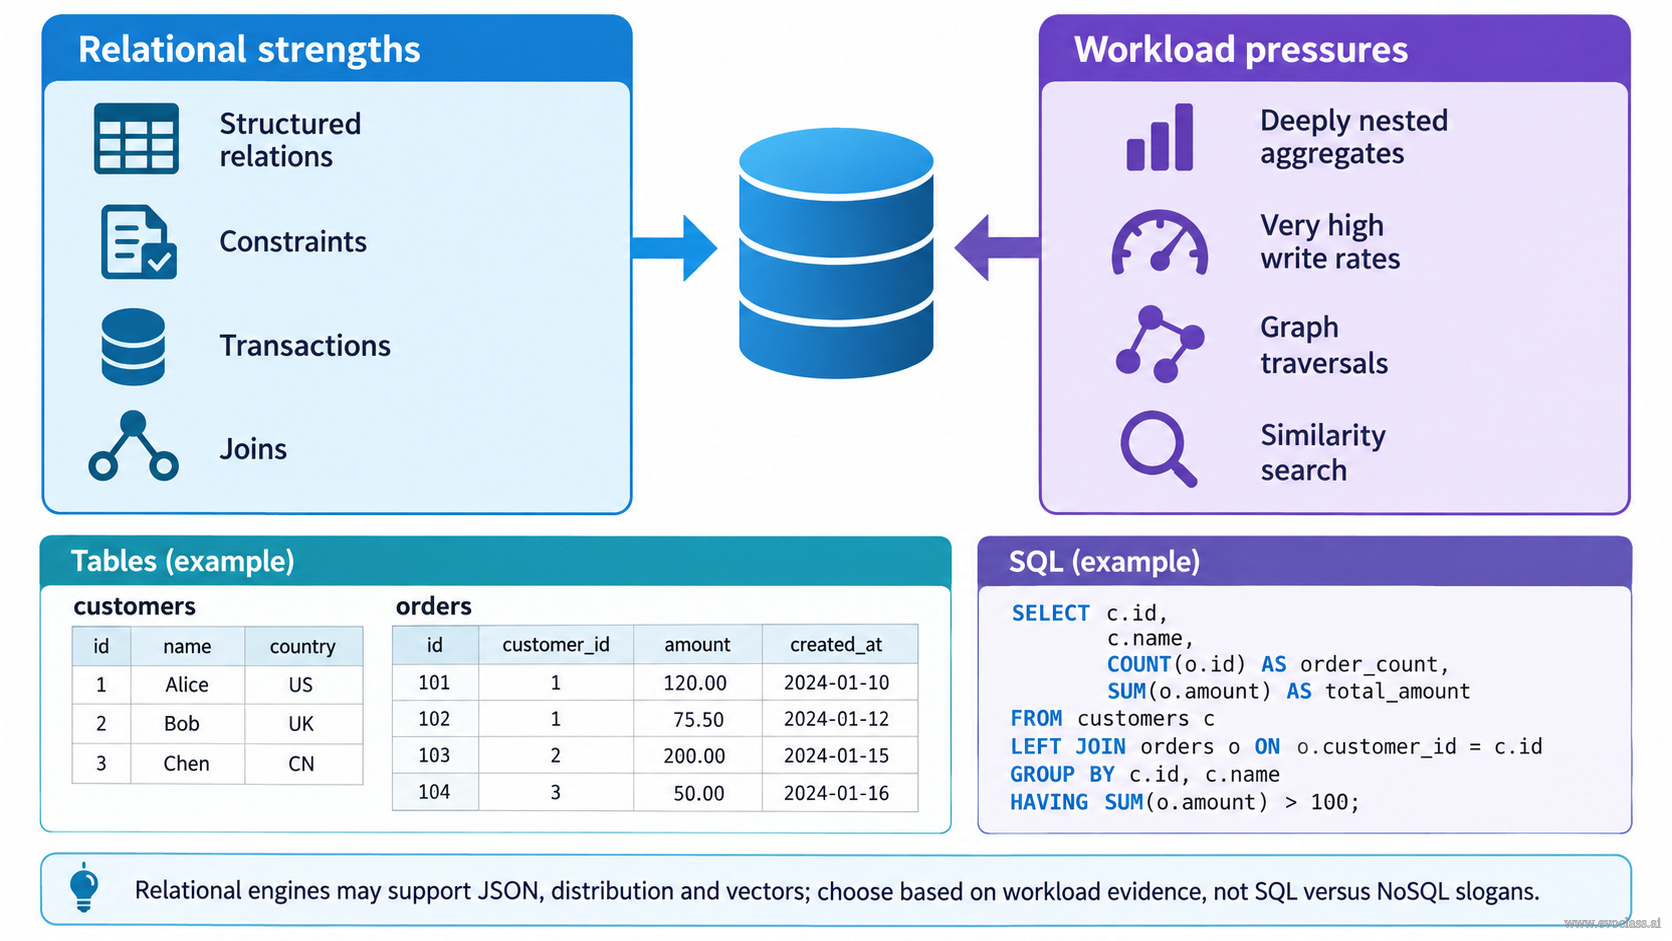
I database relazionali offrono struttura e coerenza potenti tramite tabelle normalizzate, ma presentano vincoli e limiti intrinseci quando devono affrontare le richieste di dati eterogenei e in rapida evoluzione delle moderne applicazioni software. Comprendere questi limiti architetturali è essenziale per una progettazione efficace dei sistemi.
Concetti Fondamentali
- Struttura rigida: I database relazionali si basano su tabelle fisse e altamente strutturate per garantire una rigorosa integrità dei dati e la conformità ACID.
- Richieste non strutturate: Il software moderno gestisce spesso tipi di dati eterogenei e in rapida evoluzione che non si adattano facilmente alle tradizionali righe e colonne.
- Confini Architetturali: Riconoscere questi confini aiuta gli sviluppatori a prevedere i colli di bottiglia delle prestazioni e a selezionare i paradigmi di archiviazione dati più appropriati.
Esempio Pratico
Archiviare registrazioni strutturate dei dipendenti con attributi fissi (ID, nome, dipartimento) funziona eccezionalmente bene in una tabella relazionale; tuttavia, tentare di archiviare preferenze cliente profondamente annidate, log di clickstream in tempo reale o profili utente in costante evoluzione può diventare complicato sotto una struttura rigida.
Approfondimento Architetturale
Sebbene i sistemi relazionali eccellano nei carichi di lavoro transazionali strutturati, forzare dati semi-strutturati in tabelle piatte spesso comporta colonne sparse, join complessi e prestazioni delle query ridotte.